Automatyczna ewaluacja w aplikacjach LLM: jak LlamaIndex może ułatwić ten proces
W skrócie
W miarę jak modele językowe (LLM) stają się coraz bardziej zaawansowane, rośnie potrzeba efektywnej i precyzyjnej oceny generowanych przez nie odpowiedzi.
Wprowadzenie
W miarę jak modele językowe (LLM) stają się coraz bardziej zaawansowane, rośnie potrzeba efektywnej i precyzyjnej oceny generowanych przez nie odpowiedzi. Aplikacje muszą teraz uwzględniać przetwarzanie wiedzy, w tym proces Retrieval-Augmented Generation (RAG), aby dostosować konkretne rozwiązania do swoich domen.
Istnieją dwa główne podejścia do oceny: ocena automatyczna oraz ocena oparta na ręcznie przygotowanych zestawach referencyjnych. Każde z nich ma swoje zalety i wady.
Metody oceny
Ocena ręczna oparta na zestawie referencyjnym
Ręcznie tworzone zestawy referencyjne mają kilka zalet, takich jak znajomość oczekiwanej odpowiedzi systemu dla konkretnych przypadków. Jednak mają istotne wady:
Czasochłonność: Tworzenie ręcznych zestawów referencyjnych wymaga ekspertów do przygotowania, weryfikacji i zatwierdzania każdego pytania i odpowiedzi.
Kosztowność: Zaangażowanie ekspertów generuje koszty, które szybko rosną wraz ze wzrostem liczby pytań i odpowiedzi.
Ograniczona skalowalność: Utrzymanie i aktualizacja ręcznych zestawów referencyjnych jest trudne, a zasoby ludzkie stają się wąskim gardłem.
Subiektywność: Oceny oparte na danych referencyjnych mogą być obarczone błędami i subiektywizmem.
Ograniczona różnorodność danych: Eksperci mogą nie uwzględnić wszystkich możliwych wariantów pytań i odpowiedzi.
Ocena automatyczna
Ocena automatyczna przy użyciu ewaluatorów opartych na LLM umożliwia szybkie i skalowalne, wieloaspektowe ocenianie generowanych odpowiedzi. Nowoczesne narzędzia (np. Vertex, LlamaIndex) oferują wbudowane funkcje ewaluacji, które integrują modele, umożliwiając efektywne wykrywanie halucynacji i zapewnianie spójności pytań i odpowiedzi. Ocena automatyczna przyspiesza proces oceny, obniża koszty i minimalizuje błędy ludzkie, co czyni ją nieocenioną przy pracy z zaawansowanymi modelami językowymi.
Ewaluacja w co.brick
Problem oceny jest istotny w co.brick, gdzie rozwijamy aplikacje dla naszych klientów i rozwijamy technologię CoCo. CoCo to platforma AI wykorzystująca generatywną sztuczną inteligencję do wydobywania wiedzy z systemów technicznych (cloud-native, IIoT).
Proces ewaluacji automatycznej
Proces uwzględnia pytanie użytkownika, odpowiedź systemu oraz kontekst (wybrane węzły wiedzy). Opiera się na następujących pytaniach, aby ocenić wydajność aplikacji LLM:
Ocena wierności (Faithfulness): Czy wygenerowana odpowiedź jest zgodna z kontekstem (węzłami wiedzy)?
Ocena adekwatności: Czy odpowiedź i kontekst odpowiadają zapytaniu?
Odpowiedniość kontekstu: Które węzły kontekstowe zostały użyte do wygenerowania odpowiedzi?
Inne metody i podejścia oparte na szczegółowych wytycznych zostaną przeanalizowane w przyszłych zadaniach.
Dlaczego LlamaIndex?
LlamaIndex to zaawansowane narzędzie Open Source zaprojektowane do efektywnego przetwarzania i zarządzania wiedzą w aplikacjach LLM. Wyróżnia się elastycznością i wszechstronnością, oferując wbudowane metody ewaluacji do automatycznej oceny odpowiedzi generowanych przez LLM. Pomaga to wykrywać halucynacje modelu i oceniać spójność odpowiedzi z kontekstem.
Zakładając, że mamy dokumenty (bazę wiedzy) do wykorzystania w aplikacji, LlamaIndex pozwala na łatwe przetwarzanie różnych typów dokumentów w celu utworzenia węzłów wiedzy. Wiele podstawowych przykładów użycia LlamaIndex jest dostępnych w Internecie, więc nie będziemy tutaj rozwijać tego tematu. Podstawowe użycie wygląda następująco:
documents = SimpleDirectoryReader("data").load_data()
index = VectorStoreIndex.from_documents(documents)
Na podstawie zindeksowanych danych można utworzyć wyszukiwarkę:
query_engine = index.as_query_engine()
response = query_engine.query("What does co.brick do?")
print(response)
Ocena wierności (Faithfulness)
Używając FaithfulnessEvaluator z LlamaIndex, możemy ocenić, czy odpowiedź silnika zapytań odpowiada któremukolwiek z węzłów źródłowych. Jest to kluczowe do wykrywania halucynacji modelu.
llm = OpenAI(model="gpt-3.5-turbo", temperature=0)
evaluator = FaithfulnessEvaluator(llm=llm)
contexts = [node.node.text for node in response.source_nodes]
eval_result = evaluator.evaluate(query=query, response=str(response), contexts=contexts) print(eval_result.passing)
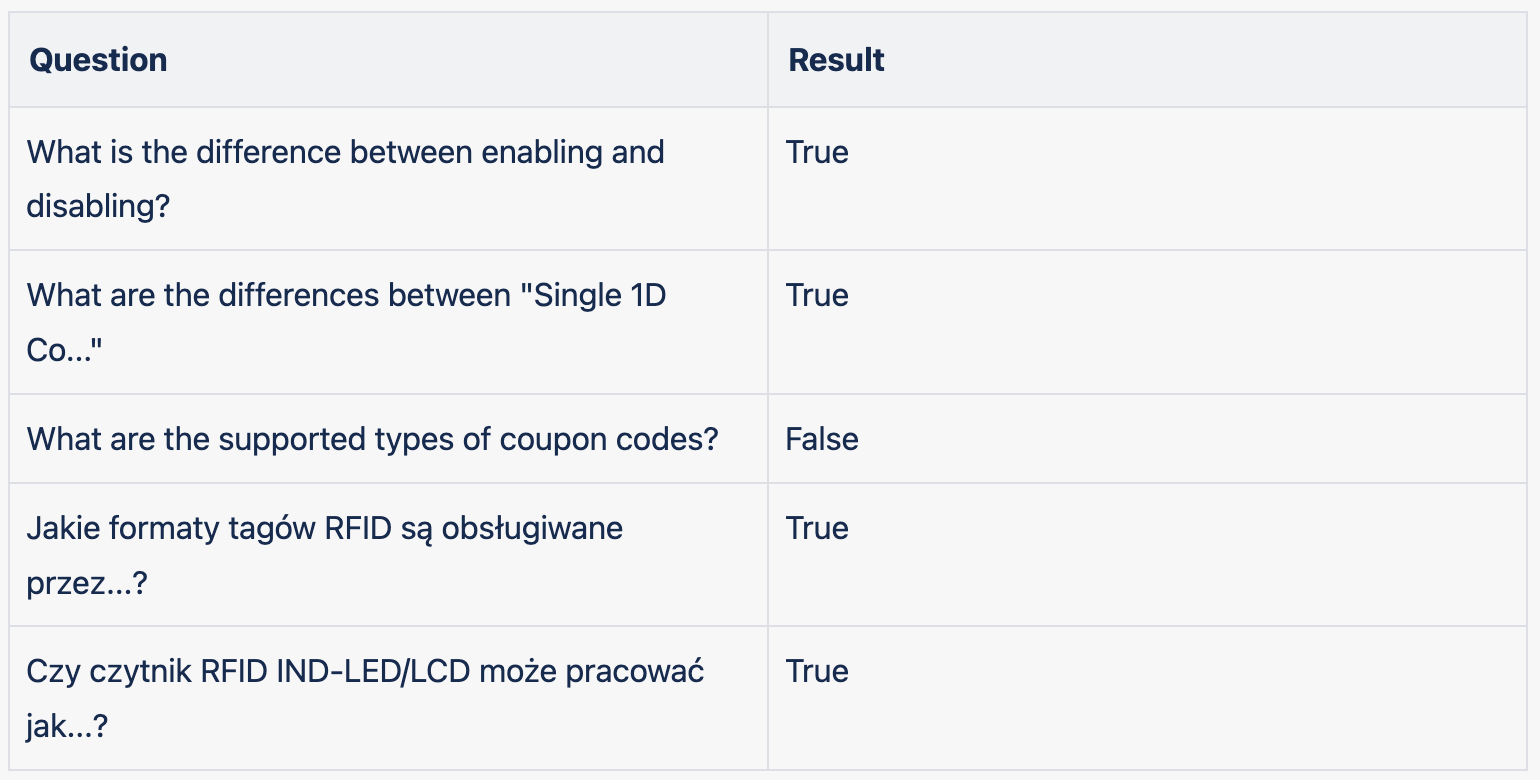
Wynik to albo True, albo False. Metodę tę można dostosować do działania na zestawie pytań referencyjnych lub automatycznie wygenerowanych pytań.
Przykładowe wyniki dla serii pytań technicznych (pytania były generowane po polsku i angielsku):
Pytania LLM i wyniki
Ewaluator odpowiedzi na zapytanie (QueryResponseEvaluator)
QueryResponseEvaluator ocenia spójność pytania i odpowiedzi (bez kontekstu). Użycie jest podobne do FaithfulnessEvaluator:
evaluator = QueryResponseEvaluator(llm=llm) response = query_engine.query(example_query)
contexts = [node.node.text for node in response.source_nodes]
eval_result = evaluator.evaluate_response(query=query, response=str(response), contexts=contexts) print(eval_result.passing)
Ewaluator trafności kontekstu (Context relevancy evaluator)
Używając RelevancyEvaluator, możemy przeanalizować trafność każdego węzła kontekstowego względem pytania i odpowiedzi, co jest niezbędne do oceny skuteczności procesu RAG.
query_engine = index.as_query_engine(similarity_top_k=6)
response = query_engine.query(example_query)
contexts = [node.node.text for node in response.source_nodes]
llm = OpenAI(temperature=0, model="gpt-4")
evaluator = RelevancyEvaluator(llm=llm)
eval_source_result_full = [evaluator.evaluate(query=example_query, response=response_vector.response, contexts=[source_node.get_content()]) for source_node in response_vector.source_nodes]

print(eval_source_result_full)
Wnioski
W naszej analizie użyliśmy LlamaIndex i jego ewaluatorów, aby ocenić zdolność systemu do odpowiadania na pytania użytkowników. Podobne ewaluatory prawdopodobnie są dostępne w innych bibliotekach. Metody automatyczne opierają się na ewaluatorach LLM, a jakość ocen zależy od modelu ewaluatora. Na przykład GPT-3 często dawał słabe wyniki, podczas gdy oceny GPT-4 były wiarygodne. Automatyczne metody ewaluacji mogą skutecznie sprawdzić, czy system jest odporny na halucynacje i optymalizować procesy tworzenia bazy wiedzy. Jednak korzystanie z tych metod wiąże się z kosztami związanymi z API modeli. W ocenie węzłów kontekstowych wymagane są większe modele. Ten tekst nie wyczerpuje tematu ewaluacji i będziemy kontynuować prace nad opracowaniem satysfakcjonujących metod automatycznej oceny dla aplikacji LLM. Zachęcam do implementacji tych metod w waszych projektach i eksperymentowania z różnymi modelami LLM, aby osiągnąć najlepsze rezultaty.
Powiązane artykuły
Transformacyjna moc generatywnej AI w prawie i zakupach
Dowiedz się, jak generatywna AI rewolucjonizuje prawo i zamówienia. Przyspiesz tworzenie umów, ulepsz due diligence, opanuj negocjacje i zautomatyzuj zadania.
Usługi zarządzane
W dzisiejszym świecie zdominowanym przez technologię firmy potrzebują więcej niż nowoczesnych narzędzi i oprogramowania, aby prosperować — potrzebują odpowiednich ludzi i infrastruktury
Managed Teams: Nowe spojrzenie na budowanie zespołów IT
Managed Teams oferuje przekonującą alternatywę dla tradycyjnego outsourcingu, szczególnie atrakcyjną dla firm poszukujących głębszej współpracy i wszechstronnego wsparcia przy tworzeniu zespołów IT.